④ 训练范式 · Pretrain(文字接龙魔鬼训练营)
Pretrain 只做一件事:遮住句尾,猜下一个字。猜错就调整 6400 万个参数。 把 127 万句猜完一遍,语言规律就进了参数。这个简单任务是一切能力的地基。
4.1 训练目标:Next Token Prediction
日? 山? 尽? 楼?"] C --> D["标签就是'下一个字'
白→日 日→依 依→山 尽→
关键认知:训练时每个位置都在同时学习,不是只学最后一个字。"白→日"教它语法,"依山尽→楼"教它知识,"尽→句号"教它停顿。一句话 340 个 token 就是 340 道练习题。
核心概念正名 · 交叉熵损失(Cross-Entropy Loss):衡量"模型的概率分布"与"正确答案"的距离。直觉版:loss = 模型对正确答案的"惊讶程度"。模型给正确字分配的概率越高,越不惊讶,loss 越低:
- 随机初始化 + 6400 词表:每个字概率 ≈ 1/6400,loss = -ln(1/6400) = ln(6400) ≈ 8.76(理论起点)
- 我实测 K2 首个记录点 loss = 7.58(词表内频率不均,低于理论上界)✓
- 训完 loss = 2.02:相当于"正确字给到约 13% 概率"(e^-2.02 ≈ 0.13)——在 6400 选 1 里这已是碾压性准确
4.2 数据是怎么喂的:PretrainDataset 逐块讲
源码 dataset/lm_dataset.py L37-55:
def __getitem__(self, index):
    sample = self.samples[index]
    # ① 文本 → token id 序列,最长 340-2(给 bos/eos 留位)
    tokens = self.tokenizer(str(sample['text']), add_special_tokens=False,
                            max_length=self.max_length - 2, truncation=True).input_ids
    # ② 首尾加特殊标记:<bos>(开头哨兵) + 正文 + <eos>(结尾哨兵)
    #    模型由此学会"何时该闭嘴"——生成出 <eos> 就停止
    tokens = [self.tokenizer.bos_token_id] + tokens + [self.tokenizer.eos_token_id]
    # ③ 不足 340 的补 <pad> 填满(把不同长度句子装进同一个方矩阵)
    input_ids = tokens + [self.tokenizer.pad_token_id] * (self.max_length - len(tokens))
    input_ids = torch.tensor(input_ids, dtype=torch.long)
    # ④ 标签 = 输入的拷贝,但 pad 位置改成 -100
    labels = input_ids.clone()
    labels[input_ids == self.tokenizer.pad_token_id] = -100
    return input_ids, labels
核心概念正名 · ignore_index=-100:CrossEntropy 的约定——标签为 -100 的位置不参与 loss(填空题里空着不算分)。Pretrain 阶段只有 pad 不算分;SFT 阶段将用同一机制实现"只学 assistant 的话"(见 4.6)。
核心概念正名 · shift(错位对齐):模型内部 logits[..., :-1] 与 labels[..., 1:] 对齐(model_minimind.py L245)——用第 1N-1 个位置去预测第 2N 个字。"接龙"在张量上就是错开一格。
4.3 训练循环:每一步发生什么
源码 trainer/train_pretrain.py train_epoch 逐块(省略日志):
lr = get_lr(epoch * iters + step, args.epochs * iters, args.learning_rate)
for param_group in optimizer.param_groups: param_group['lr'] = lr
# ① 学习率调度:手写余弦 0.55×lr → 0.1×lr(train_pretrain.py 的 get_lr)

with autocast_ctx:
    res = model(input_ids, labels=labels)      # ② 前向:算出 340 道题的平均 loss
    loss = res.loss + res.aux_loss             #    MoE 时加上负载均衡损失(dense 时恒 0)
    loss = loss / args.accumulation_steps      # ③ 梯度累积:loss 除以 8

scaler.scale(loss).backward()                  # ④ 反向:算 6400 万个数字各自该怎么调

if step % args.accumulation_steps == 0:
    scaler.unscale_(optimizer)                 # ⑤ 先把放大过的梯度缩回来
    torch.nn.utils.clip_grad_norm_(model.parameters(), args.grad_clip)  # ⑥ 梯度裁剪
    scaler.step(optimizer)                     # ⑦ 真正更新参数
    scaler.update()
    optimizer.zero_grad(set_to_none=True)      # ⑧ 清空梯度,进入下一步
Gradient Accumulation(梯度累积):batch(批次)32 太小,直接开 256 显存不够。 对策:连跑 8 次 batch=32,梯度只加不更新,第 8 次才一起更新。 数学上等价 batch=256,显存只付 32 的代价。
比喻 · 梯度裁剪:某批数据让梯度爆冲(范数突然巨大),裁剪把梯度向量"长度"按比例缩短到上限内——高速路上限速,防一个急弯翻车。
fp16(半精度)+ GradScaler(梯度缩放器):fp16 省一半显存、T4 上更快。代价:小梯度在 fp16 下会下溢变 0。 GradScaler 对策:先给 loss 乘大数放大梯度 → 更新前再除回来。 示例:梯度 0.0001 在 fp16 里丢失;先 ×1024 变成 0.1024(fp16 存得住),更新时再 ÷1024 还原。
4.4 一次真实训练的全貌(我的 K2 配置)
| 项 | 值 | 含义 |
|---|---|---|
| 模型 | 768×8 dense,63.9M 参数 | minimind-3 主线 |
| 数据 | pretrain_t2t_mini,1.24GB / 1,270,238 行 | mini 子集 |
| batch | 32 × 累积 8 = 等效 256 | max_seq_len 340 |
| 总步数 | 1,270,238 ÷ 32 = 39,695 步 | 1 epoch |
| 硬件 | Kaggle T4 16GB,fp16 | 免费 GPU |
| 耗时 | 4.9 小时 | ~9.1 秒/步 |
4.5 实战:loss 曲线与生成眼检
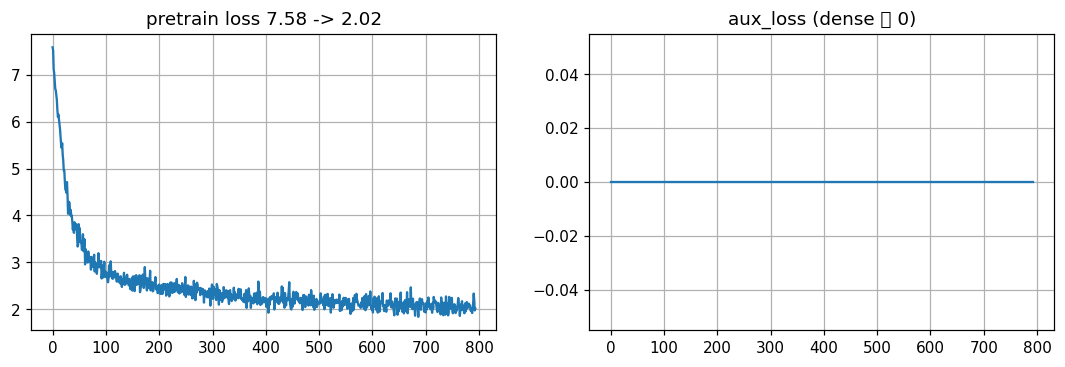
实战验证(K2 真实数据)
- loss:7.58 → 2.02(794 个记录点)。前 ~7.5k 步从 7.6 陡降到 2.5(学会高频词和语法骨架),之后 3 万步缓慢磨到 2.0(知识细节)——LLM pretrain 的标准"陡降+长尾"形态
- aux_loss 恒 0 ✓(dense 模型,验证 M0 推导)
- 生成眼检(temperature=0.85):
"中国的首都是" → "北京。"—— 1 epoch 就注入了事实知识"人工智能是" → "人工智能人工智能人工智能…"—— 复读循环- 判读:pretrain 模型会接龙但没有对话能力,且采样时容易陷入重复吸引子。这不是 bug,是阶段特征——SFT 是它的药
4.6 SFT:同一套循环,换数据与 mask
三个改动,从"背书机器"变"对话助手":
| 改动 | Pretrain | SFT |
|---|---|---|
| 数据 | 连续文章块 | 905,718 条多轮对话(messages 列表) |
| 输入拼接 | 原文切块 | Chat Template 拼接:<|im_start|>user…<|im_end|><|im_start|>assistant… |
| 学习目标 | 每个 token 都算 loss | Loss Mask:user 段标签=-100,只学 assistant 的回答 |
| 学习率 | ~1e-4 级 | 1e-5——步子大了会灾难性遗忘 |
比喻:pretrain 是把整本百科全书抄进脑子;SFT 是拿几千道"问答题标准答案"练反应——但只批改你写的答案部分(loss mask),题目本身不扣分。
K3 实测(T4 fp16,8.7h)
- loss 2.32 → 1.69:起点 2.32(不是 pretrain 那种 7+ 高位)——基座的语言能力被直接复用,SFT 只学"对话格式"
- 对话验收:自我介绍 ✅ 流利带
<think>结构;"1+1=?" ❌ 复读自我介绍——小数据 SFT 学到的是格式与身份,不是知识;数学能力缺失暴露的是数据覆盖面问题 - 中途被 Kaggle 杀过一次会话,从 checkpoint 续训完成——
--save_interval中间权重就是保险
实战:判读 SFT 效果别只看 loss——loss 1.69 只说明"像训练数据里的回答",数据本身偏科(自我认知样本多),模型就偏科。验收必须眼检真实对话。
4.7 MoE 训练实测:负载均衡是"够用",不是"均匀"
K4 kernel:150k 行从零训 MoE 版(4 专家 top-1 路由,198M 总参/64M 激活),44 分钟。
- loss 7.61 → 3.05:与 dense 同起点(7.6 级)——换 MoE 架构不改变预训练动态的本质
- aux_loss 0.0047 → 0.0040 快速趋稳:路由在训练早期就"定型"
- 专家负载热图(hook 抓每层 gate 的 top-1 选择,64 样本):
| 观察点 | 结果 |
|---|---|
| 死专家(0%) | 0 个 |
| 独大专家(>60%) | 0 个 |
| 负载范围 | 全格 18-36% |
比喻:aux_loss 像食堂排队管理员——不要求每个窗口人数一模一样,只要没人排到 1 小时、没有窗口空着就行。L3 的 E1 占 36% vs 别人 20%,属于"分工形成"而非"失衡"。
4.8 LoRA:263MB 底座不动,1.6MB 改身份
实测(Mac M4 CPU,40min):冻结 K3 的 SFT 权重,只训插入的低秩矩阵(0.61% 参数),把模型自我认知改写为自定义身份。
两个关键数字:
| 项 | 值 |
|---|---|
| LoRA 可训参数 | 0.39M / 64.3M = 0.61% |
| 适配器文件 | 1.6MB(对比全参 263MB) |
验收:520 步后,"你是谁"从发散回答变成 ✅ 自定义身份;"你和 openai 什么关系"从幻觉变成 ✅ 明确划界。
代价同样清晰:纯身份 100 条训练后,流畅度受损——出现复读、后半句崩坏。64M 小模型容量太小,新身份模式挤占了语言模式。
比喻:LoRA 像给书贴便利贴——原书一字不改,新知识写在几张小纸条上夹进去。但书的空白处就那么大,便利贴贴太多,正文反而看不清。
实战判读:LoRA 欠拟合的信号是 loss 降不动 + 输出混乱(v1:130 步 loss 3.3);过拟合信号是身份答对但通用问题变差(v2)。官方忠告"混入通用数据防遗忘"实测成立。
4.9 后续小节(完成后滚动更新)
- LoRA:不动原权重,只训插入的低秩矩阵 → M4
- DPO/RL:从"模仿答案"到"对比好坏" → M5-M8
- LoRA:冻结主体,只训小挂件 —— M4/本地实验后续写
- 蒸馏:让小模型抄大模型的"概率分布" —— K9 完成后续写
自测 3 问(用术语作答)
- 为什么随机初始化的模型 loss 理论上是 ln(6400)≈8.76?我实测首个点是 7.58,为什么比理论低?(提示:词频分布)
- batch_size=32 且 accumulation_steps=8 时,为什么 optimizer.step() 每 8 个 batch 才执行一次?等效 batch 是多少?
- GradScaler 在 fp16 训练里解决什么问题?它"先放大后缩小"各发生在哪个时机?